평균 10과 12, 표준편차 2인 정규분포에서 두 집단(각 50개)의 유전자 발현량을 만들어 t-검정을 하고, 결과를 상자그림과 점 그림으로 비교해 줘.
K
완료
실행 과정 11단계 · 44초
-
진행에이전트를 준비하고 있습니다.
-
진행질문에 맞는 도구와 데이터를 고르고 있습니다.
-
진행도구 6개, 데이터 2개, 라이브러리 10개를 골랐습니다.
-
계획생각/추론: 요청은 시뮬레이션 데이터 생성(두 정규분포, 각 n=50), 독립표본 t-검정 수행, 그리고 상자그림+점 그림으로 두 집단 비교입니다. 재현 가능하도록 난수 시드를 고정하고, 결과 표와 그림 파일을 현재 작업 디렉터리에 저장하겠습니다. 계획: 1. [ ] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. 2. [ ] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. 3. [ ] 두 집단에 대해 독립표본 t-검정을 수행한다. 4. [ ] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다. 5. [ ] 생성된 파일 경로와 주요 결과를 정리한다.
-
코드 pythonpython
import numpy as np import pandas as pd from scipy import stats import matplotlib.pyplot as plt import seaborn as sns import os print("연구 로그: 정규분포 기반 유전자 발현량 시뮬레이션 및 t-검정") print("=" * 70) # Step 1 np.random.seed(42) n = 50 mean_a = 10 mean_b = 12 sd = 2 group_a = np.random.normal(loc=mean_a, scale=sd, size=n) group_b = np.random.normal(loc=mean_b, scale=sd, size=n) print("\n1단계 완료: 데이터 생성") print(f"- Group A: N({mean_a}, {sd}^2), n={n}") print(f"- Group B: N({mean_b}, {sd}^2), n={n}") print("\n계획 업데이트:") print("1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료)") print("2. [ ] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다.") print("3. [ ] 두 집단에 대해 독립표본 t-검정을 수행한다.") print("4. [ ] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다.") print("5. [ ] 생성된 파일 경로와 주요 결과를 정리한다.") # Step 2 df = pd.DataFrame({ "group": ["Group A_mean10"] * n + ["Group B_mean12"] * n, "expression": np.concatenate([group_a, group_b]) }) summary = df.groupby("group")["expression"].agg(["count", "mean", "std", "median", "min", "max"]).reset_index() data_path = "simulated_gene_expression.csv" summary_path = "summary_statistics.csv" df.to_csv(data_path, index=False) summary.to_csv(summary_path, index=False) print("\n2단계 완료: 데이터 정리 및 요약통계 계산") print(summary.to_string(index=False)) print("\n계획 업데이트:") print("1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료)") print("2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. (완료)") print("3. [ ] 두 집단에 대해 독립표본 t-검정을 수행한다.") print("4. [ ] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다.") print("5. [ ] 생성된 파일 경로와 주요 결과를 정리한다.") # Step 3 # Equal variance assumption is reasonable because simulation uses same SD=2. t_stat, p_value = stats.ttest_ind(group_a, group_b, equal_var=True) # also compute Welch for reference t_welch, p_welch = stats.ttest_ind(group_a, group_b, equal_var=False) test_results = pd.DataFrame({ "test": ["Student_t_test_equal_var", "Welch_t_test_unequal_var"], "t_statistic": [t_stat, t_welch], "p_value": [p_value, p_welch], "n_group_a": [n, n], "n_group_b": [n, n], "mean_group_a": [np.mean(group_a), np.mean(group_a)], "mean_group_b": [np.mean(group_b), np.mean(group_b)], "mean_difference_B_minus_A": [np.mean(group_b) - np.mean(group_a), np.mean(group_b) - np.mean(group_a)] }) test_path = "t_test_results.csv" test_results.to_csv(test_path, index=False) print("\n3단계 완료: 독립표본 t-검정 수행") print(test_results.to_string(index=False)) print("\n계획 업데이트:") print("1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료)") print("2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. (완료)") print("3. [✓] 두 집단에 대해 독립표본 t-검정을 수행한다. (완료)") print("4. [ ] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다.") print("5. [ ] 생성된 파일 경로와 주요 결과를 정리한다.") # Step 4 sns.set(style="whitegrid", font_scale=1.1) plt.figure(figsize=(7, 5.5)) ax = sns.boxplot( data=df, x="group", y="expression", width=0.45, showfliers=False, palette=["#7FB3D5", "#F5B041"] ) sns.stripplot( data=df, x="group", y="expression", color="black", alpha=0.65, jitter=0.18, size=4 ) ax.set_title("Simulated gene expression: Boxplot with individual points") ax.set_xlabel("") ax.set_ylabel("Gene expression") subtitle = f"Student t-test: t = {t_stat:.3f}, p = {p_value:.3e}" ax.text( 0.5, 1.02, subtitle, transform=ax.transAxes, ha="center", va="bottom", fontsize=11 ) plt.tight_layout() plot_path = "gene_expression_box_strip_plot.png" plt.savefig(plot_path, dpi=300, bbox_inches="tight") plt.close() print("\n4단계 완료: 상자그림과 점 그림 생성 및 저장") print(f"- 그림 파일: {plot_path}") print("\n계획 업데이트:") print("1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료)") print("2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. (완료)") print("3. [✓] 두 집단에 대해 독립표본 t-검정을 수행한다. (완료)") print("4. [✓] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다. (완료)") print("5. [ ] 생성된 파일 경로와 주요 결과를 정리한다.") # Step 5 print("\n5단계 완료: 결과 파일 및 주요 결과 정리") print(f"- 원자료 CSV: {os.path.abspath(data_path)}") print(f"- 요약통계 CSV: {os.path.abspath(summary_path)}") print(f"- t-검정 결과 CSV: {os.path.abspath(test_path)}") print(f"- 그림 PNG: {os.path.abspath(plot_path)}") print(f"- 주요 결과: Group A 평균 = {np.mean(group_a):.3f}, Group B 평균 = {np.mean(group_b):.3f}") print(f"- 평균 차이(B-A) = {np.mean(group_b) - np.mean(group_a):.3f}") print(f"- Student t-test: t = {t_stat:.3f}, p = {p_value:.3e}") print("\n최종 계획 업데이트:") print("1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료)") print("2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. (완료)") print("3. [✓] 두 집단에 대해 독립표본 t-검정을 수행한다. (완료)") print("4. [✓] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다. (완료)") print("5. [✓] 생성된 파일 경로와 주요 결과를 정리한다. (완료)") print("=" * 70) -
실행 결과
실행 결과 보기
연구 로그: 정규분포 기반 유전자 발현량 시뮬레이션 및 t-검정 ====================================================================== 1단계 완료: 데이터 생성 - Group A: N(10, 2^2), n=50 - Group B: N(12, 2^2), n=50 계획 업데이트: 1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료) 2. [ ] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. 3. [ ] 두 집단에 대해 독립표본 t-검정을 수행한다. 4. [ ] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다. 5. [ ] 생성된 파일 경로와 주요 결과를 정리한다. 2단계 완료: 데이터 정리 및 요약통계 계산 group count mean std median min max Group A_mean10 50 9.549052 1.867338 9.531710 6.08066 13.704556 Group B_mean12 50 12.035562 1.748650 12.092161 6.76051 15.129287 계획 업데이트: 1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료) 2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. (완료) 3. [ ] 두 집단에 대해 독립표본 t-검정을 수행한다. 4. [ ] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다. 5. [ ] 생성된 파일 경로와 주요 결과를 정리한다. 3단계 완료: 독립표본 t-검정 수행 test t_statistic p_value n_group_a n_group_b mean_group_a mean_group_b mean_difference_B_minus_A Student_t_test_equal_var -6.872732 5.877565e-10 50 50 9.549052 12.035562 2.48651 Welch_t_test_unequal_var -6.872732 5.966607e-10 50 50 9.549052 12.035562 2.48651 계획 업데이트: 1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료) 2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. (완료) 3. [✓] 두 집단에 대해 독립표본 t-검정을 수행한다. (완료) 4. [ ] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다. 5. [ ] 생성된 파일 경로와 주요 결과를 정리한다. Plot saved to: gene_expression_box_strip_plot.png 4단계 완료: 상자그림과 점 그림 생성 및 저장 - 그림 파일: gene_expression_box_strip_plot.png 계획 업데이트: 1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료) 2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. (완료) 3. [✓] 두 집단에 대해 독립표본 t-검정을 수행한다. (완료) 4. [✓] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다. (완료) 5. [ ] 생성된 파일 경로와 주요 결과를 정리한다. 5단계 완료: 결과 파일 및 주요 결과 정리 - 원자료 CSV: /work/sessions/example/simulated_gene_expression.csv - 요약통계 CSV: /work/sessions/example/summary_statistics.csv - t-검정 결과 CSV: /work/sessions/example/t_test_results.csv - 그림 PNG: /work/sessions/example/gene_expression_box_strip_plot.png - 주요 결과: Group A 평균 = 9.549, Group B 평균 = 12.036 - 평균 차이(B-A) = 2.487 - Student t-test: t = -6.873, p = 5.878e-10 최종 계획 업데이트: 1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성한다. (완료) 2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산한다. (완료) 3. [✓] 두 집단에 대해 독립표본 t-검정을 수행한다. (완료) 4. [✓] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장한다. (완료) 5. [✓] 생성된 파일 경로와 주요 결과를 정리한다. (완료) ====================================================================== -
파일gene_expression_box_strip_plot.png
-
파일simulated_gene_expression.csv
-
파일summary_statistics.csv
-
파일t_test_results.csv
-
계획생각/추론: 시뮬레이션, 요약통계, t-검정, 시각화가 모두 완료되었습니다. 이제 관찰된 실행 결과를 바탕으로 주요 결과와 생성 파일을 간단히 정리해 드리겠습니다.
완료했습니다.
최종 계획:
1. [✓] 재현 가능한 난수 시드를 설정하고 두 집단의 유전자 발현량 데이터를 생성했다.
2. [✓] 생성된 데이터를 표 형태로 정리하고 요약통계를 계산했다.
3. [✓] 두 집단에 대해 독립표본 t-검정을 수행했다.
4. [✓] 상자그림과 점 그림을 함께 표시한 비교 그림을 생성하고 저장했다.
5. [✓] 생성된 파일 경로와 주요 결과를 정리했다.
주요 결과는 다음과 같습니다.
| 항목 | Group A, 평균 10 | Group B, 평균 12 |
|---|---:|---:|
| 표본 수 | 50 | 50 |
| 관측 평균 | 9.549 | 12.036 |
| 관측 표준편차 | 1.867 | 1.749 |
| 중앙값 | 9.532 | 12.092 |
독립표본 t-검정 결과:
- t 통계량: -6.873
- p-value: 5.878 × 10⁻¹⁰
- 평균 차이, Group B - Group A: 2.487
해석:
- 두 집단은 모두 표준편차 2인 정규분포에서 생성되었습니다.
- Group A는 평균 10, Group B는 평균 12로 설정했으며, 실제 생성된 표본 평균도 각각 약 9.55와 12.04였습니다.
- t-검정 결과 p-value가 매우 작으므로, 두 집단의 평균 발현량은 통계적으로 유의하게 다릅니다.
생성된 파일:
- 원자료 CSV: `simulated_gene_expression.csv`
- 요약통계 CSV: `summary_statistics.csv`
- t-검정 결과 CSV: `t_test_results.csv`
- 상자그림 + 점 그림 PNG: `gene_expression_box_strip_plot.png`
그림 파일 `gene_expression_box_strip_plot.png`에서 두 집단의 분포를 상자그림과 개별 점으로 함께 비교할 수 있습니다.
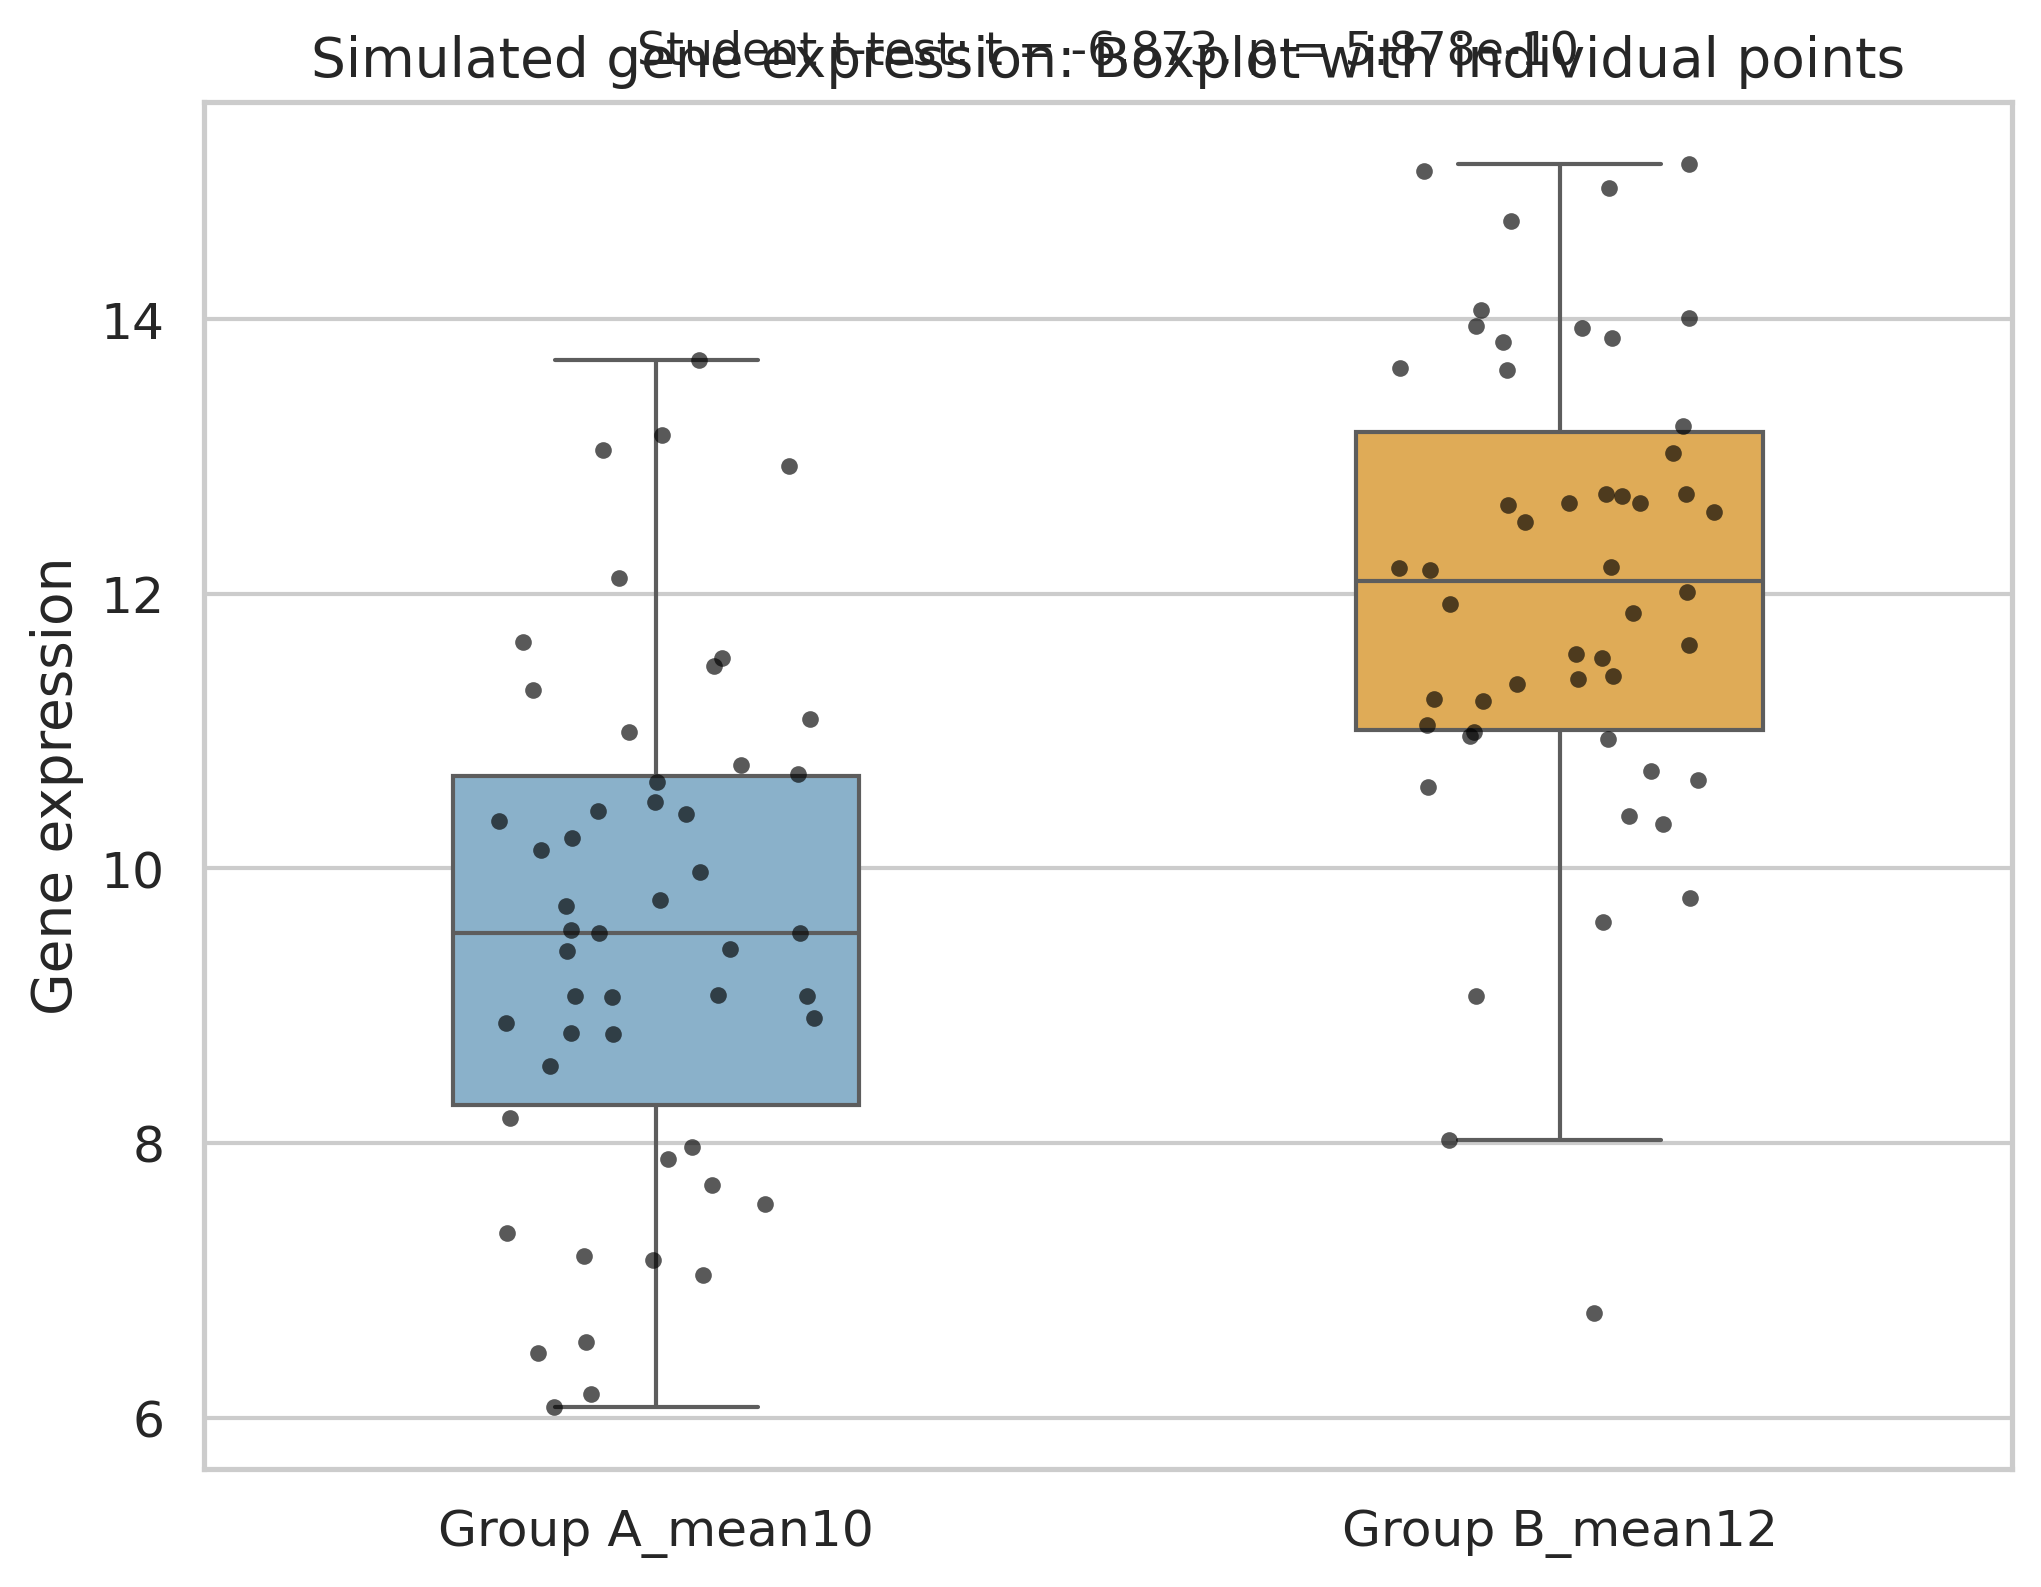 gene_expression_box_strip_plot.png
simulated_gene_expression.csv
3.3 KB
summary_statistics.csv
256 Bytes
t_test_results.csv
351 Bytes