K-Biomni가칭
둘러보기 모드 — 예시 대화를 읽기 전용으로 보여 줍니다. 질문 보내기 · 다시 생성 · 파일 첨부처럼 AI 를 부르는 기능은 요금이 나가므로, 관리자가 허가한 계정으로 로그인해야 쓸 수 있습니다.

ORF 번역 → 코돈 분석 → 그래프

ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA 서열의 ORF를 찾아 단백질로 번역해 줘.
K
실행 과정 7단계 · 34초
  1. 진행
    에이전트를 준비하고 있습니다.
  2. 진행
    질문에 맞는 도구와 데이터를 고르고 있습니다.
  3. 진행
    도구 9개, 데이터 0개, 라이브러리 3개를 골랐습니다.
  4. 계획
    생각 및 추론: 입력 서열은 DNA로 보이며 시작코돈 ATG로 시작하고 마지막에 정지코돈 TAA가 있어, 전방향에서 완전한 ORF가 있을 가능성이 큽니다. Biopython으로 3개 reading frame을 확인하고 ORF 및 번역 산물을 산출하겠습니다. 1. [ ] 입력 DNA 서열의 길이와 유효성을 확인한다. 2. [ ] 전방향 reading frame에서 시작코돈-정지코돈 ORF를 탐색한다. 3. [ ] 발견된 ORF를 단백질 서열로 번역한다. 4. [ ] 결과를 한국어로 간단히 정리한다.
  5. 코드 python
    python
    from Bio.Seq import Seq
    
    print("Step 1: 입력 서열 확인")
    seq_str = "ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA"
    seq = Seq(seq_str)
    print(f"Sequence: {seq_str}")
    print(f"Length: {len(seq_str)} nt")
    print(f"Valid DNA alphabet: {set(seq_str).issubset(set('ACGT'))}")
    
    print("\nStep 2: ORF 탐색")
    start_codons = {"ATG"}
    stop_codons = {"TAA", "TAG", "TGA"}
    
    orfs = []
    for frame in range(3):
        print(f"\nFrame +{frame+1}:")
        for i in range(frame, len(seq_str)-2, 3):
            codon = seq_str[i:i+3]
            print(f"  nt {i+1}-{i+3}: {codon}")
        # find ATG then first in-frame stop
        for i in range(frame, len(seq_str)-2, 3):
            codon = seq_str[i:i+3]
            if codon in start_codons:
                for j in range(i+3, len(seq_str)-2, 3):
                    stop = seq_str[j:j+3]
                    if stop in stop_codons:
                        orf_seq = seq_str[i:j+3]
                        cds_seq = seq_str[i:j]
                        protein = str(Seq(cds_seq).translate())
                        protein_with_stop = str(Seq(orf_seq).translate())
                        orfs.append({
                            "frame": frame+1,
                            "start_nt_1based": i+1,
                            "stop_nt_1based": j+3,
                            "start_codon": codon,
                            "stop_codon": stop,
                            "orf_seq": orf_seq,
                            "cds_seq_no_stop": cds_seq,
                            "protein": protein,
                            "protein_with_stop": protein_with_stop
                        })
                        print(f"  ORF found: nt {i+1}-{j+3}, stop={stop}")
                        break
    
    print("\nStep 3: 번역 결과")
    print(f"Number of ORFs found: {len(orfs)}")
    for idx, o in enumerate(orfs, 1):
        print(f"ORF {idx}:")
        for k, v in o.items():
            print(f"  {k}: {v}")
  6. 실행 결과
    실행 결과 보기
    Step 1: 입력 서열 확인
    Sequence: ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA
    Length: 36 nt
    Valid DNA alphabet: True
    
    Step 2: ORF 탐색
    
    Frame +1:
      nt 1-3: ATG
      nt 4-6: GCT
      nt 7-9: AGC
      nt 10-12: AAA
      nt 13-15: GGT
      nt 16-18: GAA
      nt 19-21: CTG
      nt 22-24: TTT
      nt 25-27: ACC
      nt 28-30: GGC
      nt 31-33: GTG
      nt 34-36: TAA
      ORF found: nt 1-36, stop=TAA
    
    Frame +2:
      nt 2-4: TGG
      nt 5-7: CTA
      nt 8-10: GCA
      nt 11-13: AAG
      nt 14-16: GTG
      nt 17-19: AAC
      nt 20-22: TGT
      nt 23-25: TTA
      nt 26-28: CCG
      nt 29-31: GCG
      nt 32-34: TGT
    
    Frame +3:
      nt 3-5: GGC
      nt 6-8: TAG
      nt 9-11: CAA
      nt 12-14: AGG
      nt 15-17: TGA
      nt 18-20: ACT
      nt 21-23: GTT
      nt 24-26: TAC
      nt 27-29: CGG
      nt 30-32: CGT
      nt 33-35: GTA
    
    Step 3: 번역 결과
    Number of ORFs found: 1
    ORF 1:
      frame: 1
      start_nt_1based: 1
      stop_nt_1based: 36
      start_codon: ATG
      stop_codon: TAA
      orf_seq: ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA
      cds_seq_no_stop: ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTG
      protein: MASKGELFTGV
      protein_with_stop: MASKGELFTGV*
  7. 계획
    생각 및 추론: 실행 결과에서 입력 DNA 서열은 36 nt이고, +1 reading frame에서 nt 1의 ATG부터 nt 34–36의 TAA까지 하나의 완전한 ORF가 확인되었습니다. 정지코돈을 제외한 CDS를 번역하면 단백질 서열은 `MASKGELFTGV`입니다. 1. [✓] 입력 DNA 서열의 길이와 유효성을 확인한다. 완료: 36 nt, 유효한 DNA 서열 2. [✓] 전방향 reading frame에서 시작코돈-정지코돈 ORF를 탐색한다. 완료: +1 frame에서 ORF 1개 발견 3. [✓] 발견된 ORF를 단백질 서열로 번역한다. 완료: `MASKGELFTGV` 4. [✓] 결과를 한국어로 간단히 정리한다. 완료
입력 서열: `ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA` 확인된 ORF는 1개입니다. - ORF 위치: nt 1–36 - Reading frame: +1 - 시작코돈: `ATG` - 정지코돈: `TAA` - ORF 서열: `ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA` - 정지코돈 제외 CDS: `ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTG` - 번역 단백질 서열: `MASKGELFTGV` - 정지코돈 포함 번역 표기: `MASKGELFTGV*` 따라서 단백질 번역 결과는: `MASKGELFTGV`
GPT-5.5 · 34초
이 ORF의 코돈 사용빈도와 희귀 코돈을 분석해줘
K
실행 과정 7단계 · 56초
  1. 진행
    에이전트를 준비하고 있습니다.
  2. 진행
    질문에 맞는 도구와 데이터를 고르고 있습니다.
  3. 진행
    도구 12개, 데이터 0개, 라이브러리 8개를 골랐습니다.
  4. 계획
    요청하신 ORF의 코돈 사용빈도는 바로 계산할 수 있습니다. 다만 “희귀 코돈”은 보통 발현 숙주(예: E. coli, yeast, human 등)의 코돈 사용빈도 기준으로 정의되므로, 숙주가 지정되지 않으면 엄밀한 판정은 어렵습니다. 우선 ORF 자체의 코돈 구성과 빈도를 계산하고, 참고용으로 흔히 E. coli에서 희귀/저빈도 코돈으로 간주되는 코돈 목록에 해당하는지 표시하겠습니다. 1. [ ] ORF 서열에서 정지코돈을 제외한 CDS를 3염기 코돈으로 분해한다. 2. [ ] 각 코돈의 개수, 전체 코돈 대비 빈도, 아미노산, 같은 아미노산 내 사용 비율을 계산한다. 3. [ ] 참고용 E. coli 희귀 코돈 목록과 대조해 잠재적 희귀 코돈을 표시한다. 4. [ ] 결과를 한국어로 요약하고, 숙주별 희귀 코돈 분석의 한계를 명확히 설명한다. 1. [✓] ORF 서열에서 정지코돈을 제외한 CDS를 3염기 코돈으로 분해한다. (진행 중 계산) 2. [ ] 각 코돈의 개수, 전체 코돈 대비 빈도, 아미노산, 같은 아미노산 내 사용 비율을 계산한다. 3. [ ] 참고용 E. coli 희귀 코돈 목록과 대조해 잠재적 희귀 코돈을 표시한다. 4. [ ] 결과를 한국어로 요약하고, 숙주별 희귀 코돈 분석의 한계를 명확히 설명한다.
  5. 코드 python
    python
    from collections import Counter, defaultdict
    from Bio.Data import CodonTable
    import pandas as pd
    
    print("Research log: ORF codon usage analysis")
    
    orf = "ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA"
    stop_codons = {"TAA","TAG","TGA"}
    
    # Split into codons
    codons_all = [orf[i:i+3] for i in range(0, len(orf), 3)]
    print("All codons including stop:", codons_all)
    
    # Exclude terminal stop if present
    coding_codons = codons_all[:-1] if codons_all[-1] in stop_codons else codons_all
    print("Coding codons excluding stop:", coding_codons)
    print("Number of amino-acid coding codons:", len(coding_codons))
    
    # Standard genetic code
    table = CodonTable.unambiguous_dna_by_name["Standard"]
    codon_to_aa = {}
    for aa, codon_list in table.back_table.items():
        if aa != None:
            pass
    # Build codon-to-aa from forward table
    codon_to_aa = table.forward_table.copy()
    for st in table.stop_codons:
        codon_to_aa[st] = "*"
    
    # Synonymous codons per amino acid
    aa_to_codons = defaultdict(list)
    for codon, aa in table.forward_table.items():
        aa_to_codons[aa].append(codon)
    
    codon_counts = Counter(coding_codons)
    aa_counts = Counter(codon_to_aa[c] for c in coding_codons)
    
    # Commonly cited E. coli rare/low-usage codons (reference-style screening, host-specific caveat)
    # Includes Arg AGA/AGG/CGA, Ile ATA, Leu CTA, Pro CCC; sometimes Gly GGA and Ser AGG? no AGG is Arg.
    ecoli_rare_codons = {"AGA", "AGG", "CGA", "ATA", "CTA", "CCC"}
    
    rows = []
    for codon in sorted(codon_counts):
        aa = codon_to_aa[codon]
        count = codon_counts[codon]
        total_freq = count / len(coding_codons)
        aa_specific_freq = count / aa_counts[aa]
        rows.append({
            "Codon": codon,
            "Amino_acid": aa,
            "Count": count,
            "Frequency_of_all_coding_codons": round(total_freq, 4),
            "Percent_of_all_coding_codons": round(total_freq * 100, 2),
            "Within_amino_acid_fraction_in_this_ORF": round(aa_specific_freq, 4),
            "E_coli_rare_codon_reference_flag": "Yes" if codon in ecoli_rare_codons else "No"
        })
    
    df = pd.DataFrame(rows)
    print("\nCodon usage table:")
    print(df.to_string(index=False))
    
    # amino acid sequence
    protein = "".join(codon_to_aa[c] for c in coding_codons)
    print("\nProtein sequence:", protein)
    
    # Additional summaries
    gc = (orf.count("G") + orf.count("C")) / len(orf)
    cds = "".join(coding_codons)
    gc_cds = (cds.count("G") + cds.count("C")) / len(cds)
    gc3 = sum(1 for c in coding_codons if c[2] in "GC") / len(coding_codons)
    print("\nGC content ORF including stop:", round(gc*100, 2), "%")
    print("GC content CDS excluding stop:", round(gc_cds*100, 2), "%")
    print("GC3 content CDS:", round(gc3*100, 2), "%")
    
    rare_present = [c for c in coding_codons if c in ecoli_rare_codons]
    print("\nPotential E. coli rare codons present:", rare_present if rare_present else "None")
    
    # Save output table
    out_path = "orf_codon_usage_analysis.csv"
    df.to_csv(out_path, index=False)
    print("\nSaved table:", out_path)
  6. 실행 결과
    실행 결과 보기
    Research log: ORF codon usage analysis
    All codons including stop: ['ATG', 'GCT', 'AGC', 'AAA', 'GGT', 'GAA', 'CTG', 'TTT', 'ACC', 'GGC', 'GTG', 'TAA']
    Coding codons excluding stop: ['ATG', 'GCT', 'AGC', 'AAA', 'GGT', 'GAA', 'CTG', 'TTT', 'ACC', 'GGC', 'GTG']
    Number of amino-acid coding codons: 11
    
    Codon usage table:
    Codon Amino_acid  Count  Frequency_of_all_coding_codons  Percent_of_all_coding_codons  Within_amino_acid_fraction_in_this_ORF E_coli_rare_codon_reference_flag
      AAA          K      1                          0.0909                          9.09                                     1.0                               No
      ACC          T      1                          0.0909                          9.09                                     1.0                               No
      AGC          S      1                          0.0909                          9.09                                     1.0                               No
      ATG          M      1                          0.0909                          9.09                                     1.0                               No
      CTG          L      1                          0.0909                          9.09                                     1.0                               No
      GAA          E      1                          0.0909                          9.09                                     1.0                               No
      GCT          A      1                          0.0909                          9.09                                     1.0                               No
      GGC          G      1                          0.0909                          9.09                                     0.5                               No
      GGT          G      1                          0.0909                          9.09                                     0.5                               No
      GTG          V      1                          0.0909                          9.09                                     1.0                               No
      TTT          F      1                          0.0909                          9.09                                     1.0                               No
    
    Protein sequence: MASKGELFTGV
    
    GC content ORF including stop: 47.22 %
    GC content CDS excluding stop: 51.52 %
    GC3 content CDS: 54.55 %
    
    Potential E. coli rare codons present: None
    
    Saved table: orf_codon_usage_analysis.csv
  7. 파일
    orf_codon_usage_analysis.csv
분석 결과를 확인했습니다. 이전 요약에서 GC3 값을 잘못 적은 부분이 있었고, 실행 결과 기준으로 **GC3 = 54.55%**가 맞습니다. ## 최종 코돈 사용빈도 분석 분석한 ORF: `ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA` 정지코돈 `TAA`를 제외한 coding sequence: `ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTG` 번역 단백질: `MASKGELFTGV` --- ## 1. 코돈 구성 | 순서 | 코돈 | 아미노산 | |---:|---|---| | 1 | ATG | M | | 2 | GCT | A | | 3 | AGC | S | | 4 | AAA | K | | 5 | GGT | G | | 6 | GAA | E | | 7 | CTG | L | | 8 | TTT | F | | 9 | ACC | T | | 10 | GGC | G | | 11 | GTG | V | | 12 | TAA | Stop | 정지코돈을 제외하면 총 **11개 coding codon**이 있습니다. --- ## 2. 코돈 사용빈도 | 코돈 | 아미노산 | 개수 | 전체 coding codon 중 비율 | E. coli 희귀 코돈 여부 | |---|---:|---:|---:|---| | AAA | K | 1 | 9.09% | No | | ACC | T | 1 | 9.09% | No | | AGC | S | 1 | 9.09% | No | | ATG | M | 1 | 9.09% | No | | CTG | L | 1 | 9.09% | No | | GAA | E | 1 | 9.09% | No | | GCT | A | 1 | 9.09% | No | | GGC | G | 1 | 9.09% | No | | GGT | G | 1 | 9.09% | No | | GTG | V | 1 | 9.09% | No | | TTT | F | 1 | 9.09% | No | 이 ORF는 짧기 때문에 각 코돈이 대부분 1회씩만 등장합니다. 따라서 이 서열만으로 강한 코돈 편향성을 판단하기는 어렵습니다. --- ## 3. 같은 아미노산 내 코돈 사용 중복으로 등장하는 아미노산은 glycine, 즉 **G**입니다. | 아미노산 | 코돈 | 개수 | 해당 아미노산 내 비율 | |---|---|---:|---:| | G | GGT | 1 | 50% | | G | GGC | 1 | 50% | 나머지 아미노산은 각각 1회만 등장하므로, 동의코돈 선호성을 평가하기 어렵습니다. --- ## 4. GC 함량 | 항목 | 값 | |---|---:| | ORF 전체 GC 함량, 정지코돈 포함 | 47.22% | | CDS GC 함량, 정지코돈 제외 | 51.52% | | CDS GC3 함량 | 54.55% | GC3는 coding codon의 세 번째 염기가 G 또는 C인 비율입니다. 이 CDS에서는 11개 coding codon 중 6개의 세 번째 염기가 G 또는 C이므로: `6 / 11 = 54.55%` --- ## 5. 희귀 코돈 분석 희귀 코돈은 발현 숙주에 따라 달라집니다. 여기서는 참고용으로 흔히 **E. coli에서 희귀 또는 저빈도 코돈**으로 간주되는 다음 코돈들과 비교했습니다. `AGA, AGG, CGA, ATA, CTA, CCC` 분석 대상 ORF의 coding codon: `ATG GCT AGC AAA GGT GAA CTG TTT ACC GGC GTG` 위 목록과 비교했을 때, 이 ORF에는 해당하는 E. coli 희귀 코돈이 없습니다. ## 결론 - 번역 단백질: `MASKGELFTGV` - 총 coding codon 수: 11개 - 대표적인 E. coli 희귀 코돈: 검출되지 않음 - CDS GC 함량: 51.52% - GC3 함량: 54.55% - ORF가 매우 짧아 코돈 사용 편향성 해석에는 제한이 있습니다.
GPT-5.5 · 56초
이 ORF의 코돈 사용을 막대그래프로 그려줄래?
K
실행 과정 9단계 · 32초
  1. 진행
    에이전트를 준비하고 있습니다.
  2. 진행
    질문에 맞는 도구와 데이터를 고르고 있습니다.
  3. 진행
    도구 19개, 데이터 1개, 라이브러리 15개를 골랐습니다.
  4. 계획
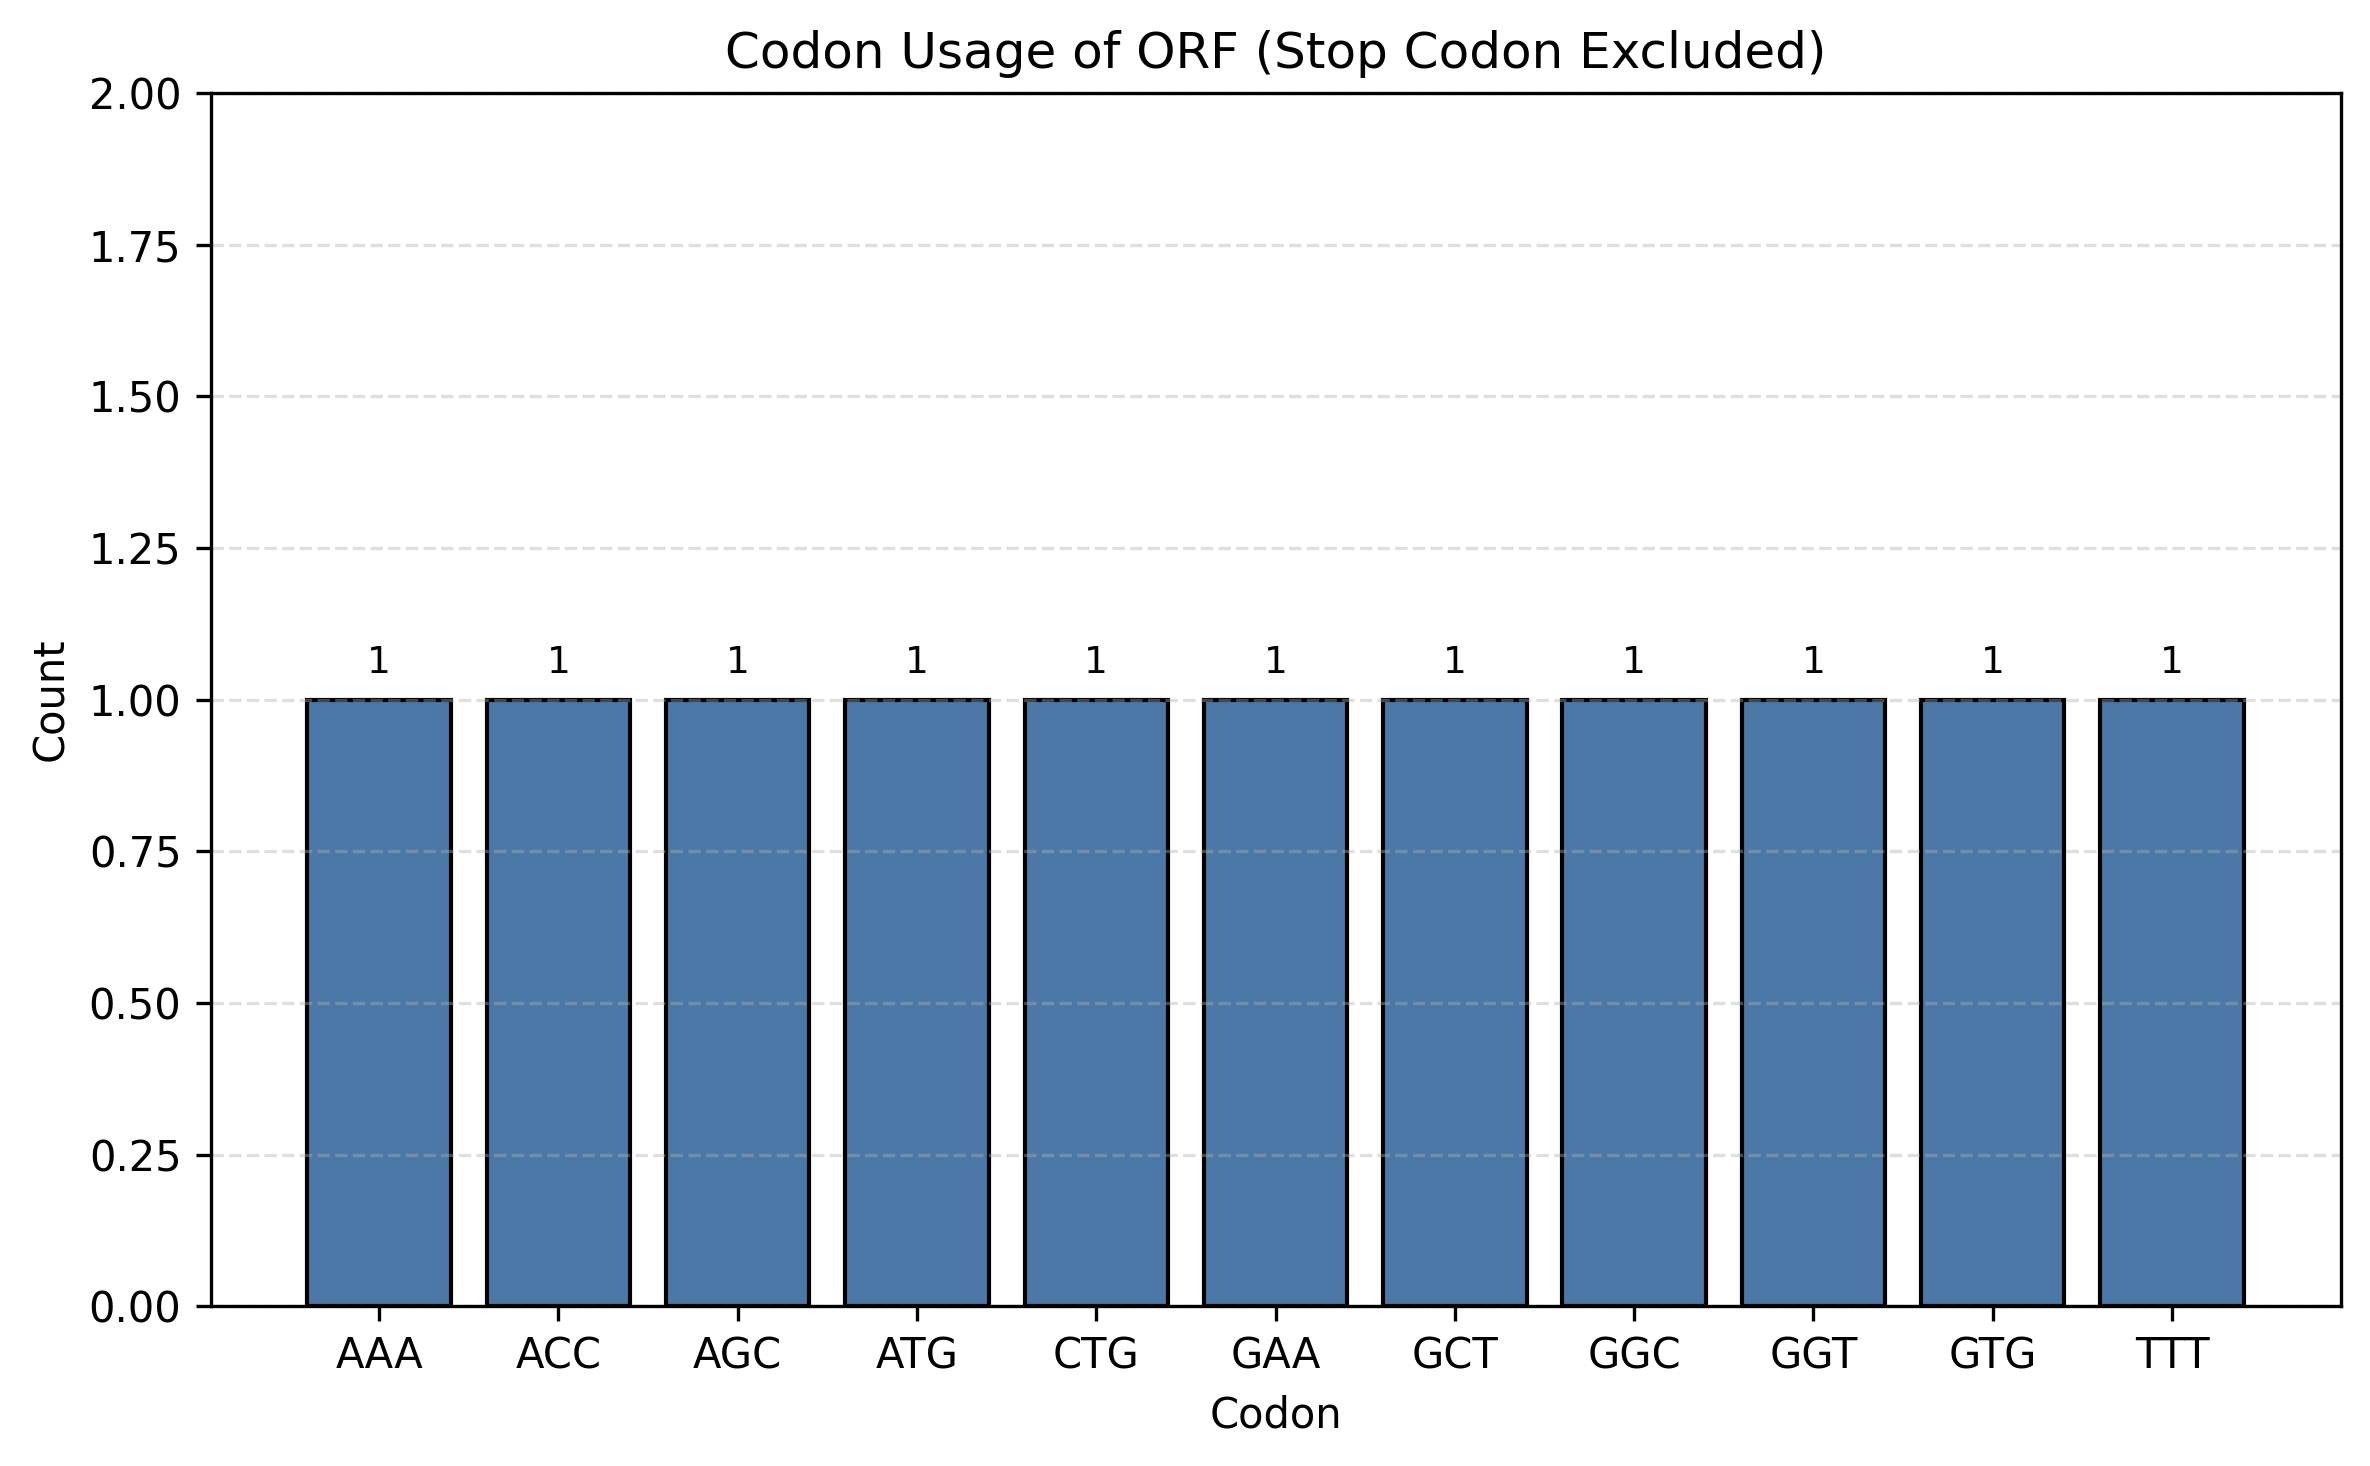
    요청하신 ORF의 코돈별 등장 횟수를 계산해 막대그래프로 저장하겠습니다. 이전 분석의 coding codon 11개(정지코돈 제외)를 사용하고, 그림 파일을 현재 작업 디렉터리에 저장해 다운로드할 수 있게 하겠습니다. 1. [ ] 입력 ORF에서 정지코돈을 제외한 coding codon 목록을 생성한다. 2. [ ] 코돈별 빈도표를 계산하고 CSV로 저장한다. 3. [ ] 코돈 사용 빈도를 막대그래프로 시각화하고 PNG 파일로 저장한다. 4. [ ] 생성된 파일과 주요 결과를 사용자에게 보고한다.
  5. 코드 python
    python
    from collections import Counter
    import pandas as pd
    import matplotlib.pyplot as plt
    
    print("Step 1: Define ORF and split into codons")
    orf = "ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA"
    codons_all = [orf[i:i+3] for i in range(0, len(orf), 3)]
    stop_codons = {"TAA", "TAG", "TGA"}
    coding_codons = [c for c in codons_all if c not in stop_codons]
    
    print("ORF:", orf)
    print("All codons:", codons_all)
    print("Coding codons excluding stop:", coding_codons)
    print("Number of coding codons:", len(coding_codons))
    
    print("\nStep 2: Count codon usage and save table")
    counts = Counter(coding_codons)
    df = pd.DataFrame({
        "codon": list(counts.keys()),
        "count": list(counts.values())
    }).sort_values(["count", "codon"], ascending=[False, True])
    df["frequency_percent"] = df["count"] / len(coding_codons) * 100
    
    csv_path = "orf_codon_usage.csv"
    df.to_csv(csv_path, index=False)
    print("Saved CSV:", csv_path)
    print(df.to_string(index=False))
    
    print("\nStep 3: Plot codon usage bar graph and save PNG")
    plt.figure(figsize=(8, 5))
    bars = plt.bar(df["codon"], df["count"], color="#4C78A8", edgecolor="black")
    plt.xlabel("Codon")
    plt.ylabel("Count")
    plt.title("Codon Usage of ORF (Stop Codon Excluded)")
    plt.ylim(0, max(df["count"]) + 1)
    plt.grid(axis="y", linestyle="--", alpha=0.4)
    
    for bar in bars:
        height = bar.get_height()
        plt.text(
            bar.get_x() + bar.get_width()/2,
            height + 0.03,
            str(int(height)),
            ha="center",
            va="bottom",
            fontsize=9
        )
    
    plt.tight_layout()
    png_path = "orf_codon_usage_barplot.png"
    plt.savefig(png_path, dpi=300, bbox_inches="tight")
    plt.close()
    
    print("Saved plot:", png_path)
    
    print("\nStep 4: Output files created")
    print({"csv": csv_path, "png": png_path})
  6. 실행 결과
    실행 결과 보기
    Step 1: Define ORF and split into codons
    ORF: ATGGCTAGCAAAGGTGAACTGTTTACCGGCGTGTAA
    All codons: ['ATG', 'GCT', 'AGC', 'AAA', 'GGT', 'GAA', 'CTG', 'TTT', 'ACC', 'GGC', 'GTG', 'TAA']
    Coding codons excluding stop: ['ATG', 'GCT', 'AGC', 'AAA', 'GGT', 'GAA', 'CTG', 'TTT', 'ACC', 'GGC', 'GTG']
    Number of coding codons: 11
    
    Step 2: Count codon usage and save table
    Saved CSV: orf_codon_usage.csv
    codon  count  frequency_percent
      AAA      1           9.090909
      ACC      1           9.090909
      AGC      1           9.090909
      ATG      1           9.090909
      CTG      1           9.090909
      GAA      1           9.090909
      GCT      1           9.090909
      GGC      1           9.090909
      GGT      1           9.090909
      GTG      1           9.090909
      TTT      1           9.090909
    
    Step 3: Plot codon usage bar graph and save PNG
    Plot saved to: orf_codon_usage_barplot.png
    Saved plot: orf_codon_usage_barplot.png
    
    Step 4: Output files created
    {'csv': 'orf_codon_usage.csv', 'png': 'orf_codon_usage_barplot.png'}
  7. 파일
    orf_codon_usage.csv
  8. 파일
    orf_codon_usage_barplot.png
  9. 계획
    요청하신 막대그래프 생성이 완료되었습니다. 1. [✓] 입력 ORF에서 정지코돈을 제외한 coding codon 목록을 생성했다. 2. [✓] 코돈별 빈도표를 계산하고 CSV로 저장했다. 3. [✓] 코돈 사용 빈도를 막대그래프로 시각화하고 PNG 파일로 저장했다. 4. [✓] 생성된 파일과 주요 결과를 사용자에게 보고한다.
생성된 파일은 다음과 같습니다. - 코돈 사용 빈도표: `orf_codon_usage.csv` - 코돈 사용 막대그래프: `orf_codon_usage_barplot.png` 분석에는 정지코돈 `TAA`를 제외한 11개 coding codon을 사용했습니다. | Codon | Count | Frequency | |---|---:|---:| | AAA | 1 | 9.09% | | ACC | 1 | 9.09% | | AGC | 1 | 9.09% | | ATG | 1 | 9.09% | | CTG | 1 | 9.09% | | GAA | 1 | 9.09% | | GCT | 1 | 9.09% | | GGC | 1 | 9.09% | | GGT | 1 | 9.09% | | GTG | 1 | 9.09% | | TTT | 1 | 9.09% | 이 ORF에서는 정지코돈을 제외한 모든 코돈이 각각 1회씩 등장하므로, 막대그래프에서 각 코돈의 높이는 모두 동일합니다.
GPT-5.5 · 32초
로그인하면 질문할 수 있습니다
K-Biomni는 실수할 수 있습니다 · 공개·비민감 자료만 넣어 주세요